重複コンテンツとは?SEOへの影響と対策方法を実務事例で解説
こんにちは。株式会社IMANIの星野です。 「重複ページを見つけたら、とりあえずnoindexにする」。大規模サイトでは、この判断が獲得できる検索需要まで消してしまうことがあります。一方、重要なページと同じ役割のURLを放置すると、狙ったページが検索結果に表示されないこともあります。 本記事では、これまでの大規模サイトでの実務経験を踏まえ、重複の確認方法とcanonical・301リダイレクト・noindexの使い分けを解説します。私が支援した求人サイト、アパレルEC、会場比較サイトで実際に何を確認し、どのページを残したかも紹介します。判断の出発点はURL数ではなく、各ページがどの検索意図に応え、事業上どんな役割を持つかです。
目次
- 重複コンテンツとは?まず押さえたい基本
- Googleが定義する重複コンテンツ
- 内部重複と外部重複の2つの種類
- 内部重複の具体例と発生パターン
- 外部重複の具体例と発生パターン
- 誤解しやすい『類似コンテンツ』との違い
- 似たページを統合するか:ドレス一覧とランキングの例
- 重複コンテンツが発生する主な原因
- URLパラメータの付与
- wwwあり・なしの重複
- HTTPとHTTPSの混在
- PC版とスマートフォン版ページの重複
- CMS・ECプラットフォームの自動生成
- サイト内検索結果ページ
- 意図しないコンテンツ複製
- Googleは重複コンテンツをどう判定するのか
- Googleの判定基準と判定方法
- コンテンツ一致率の基準
- テキスト以外の判定対象(画像・構造・メタデータ)
- 正規URLの自動選択メカニズム
- 重複コンテンツのSEOへの影響
- 被リンク評価の分散による順位低下
- クロールバジェットの無駄遣い
- 大規模サイトでの深刻度
- ユーザー体験の悪化
- 検索結果表示の不安定性
- 重複コンテンツはペナルティになるのか
- Googleの公式見解『ペナルティではない』
- ペナルティが課される例外ケース
- 評価の分散と手動ペナルティの違い
- 重複コンテンツの確認・チェック方法
- Google Search Consoleでの確認
- 「ページ」レポートとURL検査の見方
- 手動による対策の確認
- site:検索による補助的な確認
- クロールツールによる自動チェック
- 外部転載の補助的なチェック
- テキスト検索による手動チェック
- 重複コンテンツ対策の3大手法と使い分け
- Canonicalタグによる対策
- 設定方法と実装の注意点
- canonicalで解消しきれないケースの対処
- 301リダイレクトによる対策
- 設定方法と期待できる効果
- noindexタグによる対策
- noindexを使うべき場面
- 手法ごとの選択基準フレームワーク
- URLパラメータが原因の重複対策
- 動的パラメータの制御方法
- Search Consoleの旧パラメータ機能と現在の対処
- wwwあり・なしの正規化対策
- 優先するドメイン形式の決定
- 301リダイレクトまたはcanonicalによる統一
- CMS・ECサイト・求人サイトなど形態別対策
- WordPressでの重複対策
- ECサイト(Shopify・WooCommerceなど)での対策
- 商品カテゴリの重複ページ対策
- ソート・フィルター機能による重複対策
- 求人サイト・ディレクトリサイトでの対策
- 大規模DBサイトでの対策
- 外部重複・無断転載への対応
- 他社によるコンテンツ無断転載の対策
- 削除依頼とGoogleへの申告
- 重複コンテンツ対策の優先度の決め方
- 影響度×実装難易度マトリクス
- 優先的に対処すべき重複コンテンツ
- 重複コンテンツ対策を含む改善事例
- 求人サイト:canonicalで見えた改善と、残った課題
- 大規模アパレルEC:絞り込みを全部消さず、残す掛け合わせを設計
- 結婚式場比較サイト:検索結果ページと旧ディレクトリを整理
- 重複コンテンツ対策のよくある誤解
- 『重複コンテンツ=自動でペナルティ』という誤解
- 『canonicalを設定すれば100%従う』という誤解
- 『少しの違いなら重複にならない』という誤解
- 重複コンテンツ対策後の効果測定方法
- Google Search Consoleでの効果測定
- 改善前後の流入数・順位の比較
- 今すぐできる重複コンテンツ対策の実行手順
- 1. 重複URLを発見する
- 2. 優先度と対策方針を決める
- 3. 実装し、重要ページへの影響を確認する
- 重複コンテンツ対策ならIMANIにおまかせください
重複コンテンツとは?まず押さえたい基本
重複コンテンツとは、複数のURLで同一または非常によく似た内容が提供されている状態です。Googleは類似するページ群から検索結果に表示する代表のURL(正規URL)を選びます。URLパラメータや印刷用ページなど、意図せず生じる重複もあります。詳しくはGoogleの正規化に関する説明も参照してください。
Googleが定義する重複コンテンツ
Googleは「本文の何%以上が一致したら重複」といった固定の基準を公開していません。私は本文の一致だけでなく、ページの主要な情報や用途が同じか、別の検索需要に応えているかを見て判断します。
タイトルや見出しの重複はページの役割を見直す手がかりになります。ただし、同じタイトルやテンプレートを使うだけでページ全体が重複と決まるわけではありません。商品や求人の固有情報、検索意図、Googleが選んだ正規URLを合わせて確認します。
内部重複と外部重複の2つの種類
重複コンテンツには2つの種類があります。内部重複は自社ドメイン内での重複を指し、外部重複は自社と別ドメインとのコンテンツ重複を指します。重複の判定原理は共通していますが、実務で取れる対処は大きく異なります。
内部重複では、残すURLを決めて不要なURLはリダイレクト、併存させるURLはcanonicalなどで正規ページを示し、内部リンクやサイトマップも整理します。一方、外部重複では相手側の設定を変更できないことが多いため、掲載内容や媒体ごとの役割を考えることが中心となります。例えば、Xと自社ブログで同じテーマを扱う場合、Xでは要点を伝えつつ自社ブログでは詳しく解説するなど、媒体ごとに異なる価値を提供する工夫が大切です。
内部重複の具体例と発生パターン
最も多いのはURL違いによる技術的な重複です。URLパラメータの有無、末尾「/」の有無、wwwあり・なし、http・httpsの混在といったケースが該当します。何も施策を打たないまま放置されていることも多く、特に大規模サイトでは深刻な問題となります。
ECサイトでは絞り込みページや並び替えページにて、URLは異なるが表示される商品がほぼ同一となるケースが非常に多いです。求人サイトでは勤務地や雇用形態など複数条件の組み合わせによって、内容が類似したページが大量に生成されます。
サービスサイトやオウンドメディアでは情報設計・キーワード設計が原因となる内部重複が非常に多く見られます。例えば「オフィス仲介」というテーマについてトップページとサービスページの両方で対策してしまい、同じキーワードでランディングページが分散するケースです。記事制作でも検索意図が近いページを複数作成してしまい、同一キーワードでランディングページが分散するケースが非常に多くあります。
外部重複の具体例と発生パターン
記事の全文や一部を無断転載されるケースがあります。最近では生成AIの普及により、既存コンテンツを参考にした類似記事が短時間で大量に作成されるケースが増加しています。
他にもAIリライトサイトが既存コンテンツを参考に類似記事を大量生成するケース、まとめサイト・キュレーションサイトが転載・過度な引用を行うケースが該当します。代理店・加盟店・フランチャイズサイトで共通コンテンツを掲載する場合、メーカーの商品説明文・プレスリリースを複数サイトがそのまま掲載するケースもあります。
技術的な原因としては、テスト環境・ステージング環境が誤ってインデックスされるケース、開発環境・検証環境が公開状態のままクロールされるケースが挙げられます。ドメイン変更やサイトリニューアル時に旧サイト・新サイトが同時にインデックスされるケースや、他ドメインへの記事シンジケーション(転載・配信)により複数サイトへ同一記事が掲載されるケースも外部重複に該当します。
他サイトに同じ内容が載っていても、自社ページが必ず不利になるわけではありません。転載先が検索結果に選ばれているか、自社ページの表示や流入に影響しているかを、まず確認します。検索結果に表示されるURLだけから「どちらが先に公開したか」を断定しないようにしています。
無断転載への対応は、掲載状況と実際の影響を確認してから判断します。必要に応じて掲載先への削除依頼や、権利関係を確認したうえでのGoogleへの著作権侵害の申告を検討します。
誤解しやすい『類似コンテンツ』との違い
Googleは「類似コンテンツ」と「重複コンテンツ」を数値で区別していません。検索ユーザーが得られる情報や満たされる検索意図がほぼ同じで、検索結果に両方表示する価値が低いページは、重複コンテンツとして扱われやすいです。
テーマが似ていても、対象ユーザー、得られる情報、検索意図が違えば、別ページとして成立する可能性があります。一方、本文の表現だけを変え、同じ問いに同じ答えを返すページを増やしても、役割は分かれません。ここで注意したいのは、検索意図が近いページ同士の競合と、Googleが重複URLとして同じグループにまとめることは同義ではない点です。前者はクエリとページの役割、後者はURL検査の正規URL選択まで見て切り分けます。
似たページを統合するか:ドレス一覧とランキングの例
たとえばドレスECに「ドレス一覧」と「人気ドレスのランキング」があるとします。ページの一部で同じ商品を紹介していても、一覧が「レンタルドレス」、ランキングが「人気ドレス」「ドレス おすすめ」といった固有のクエリを獲得しているなら、すぐに統合しません。
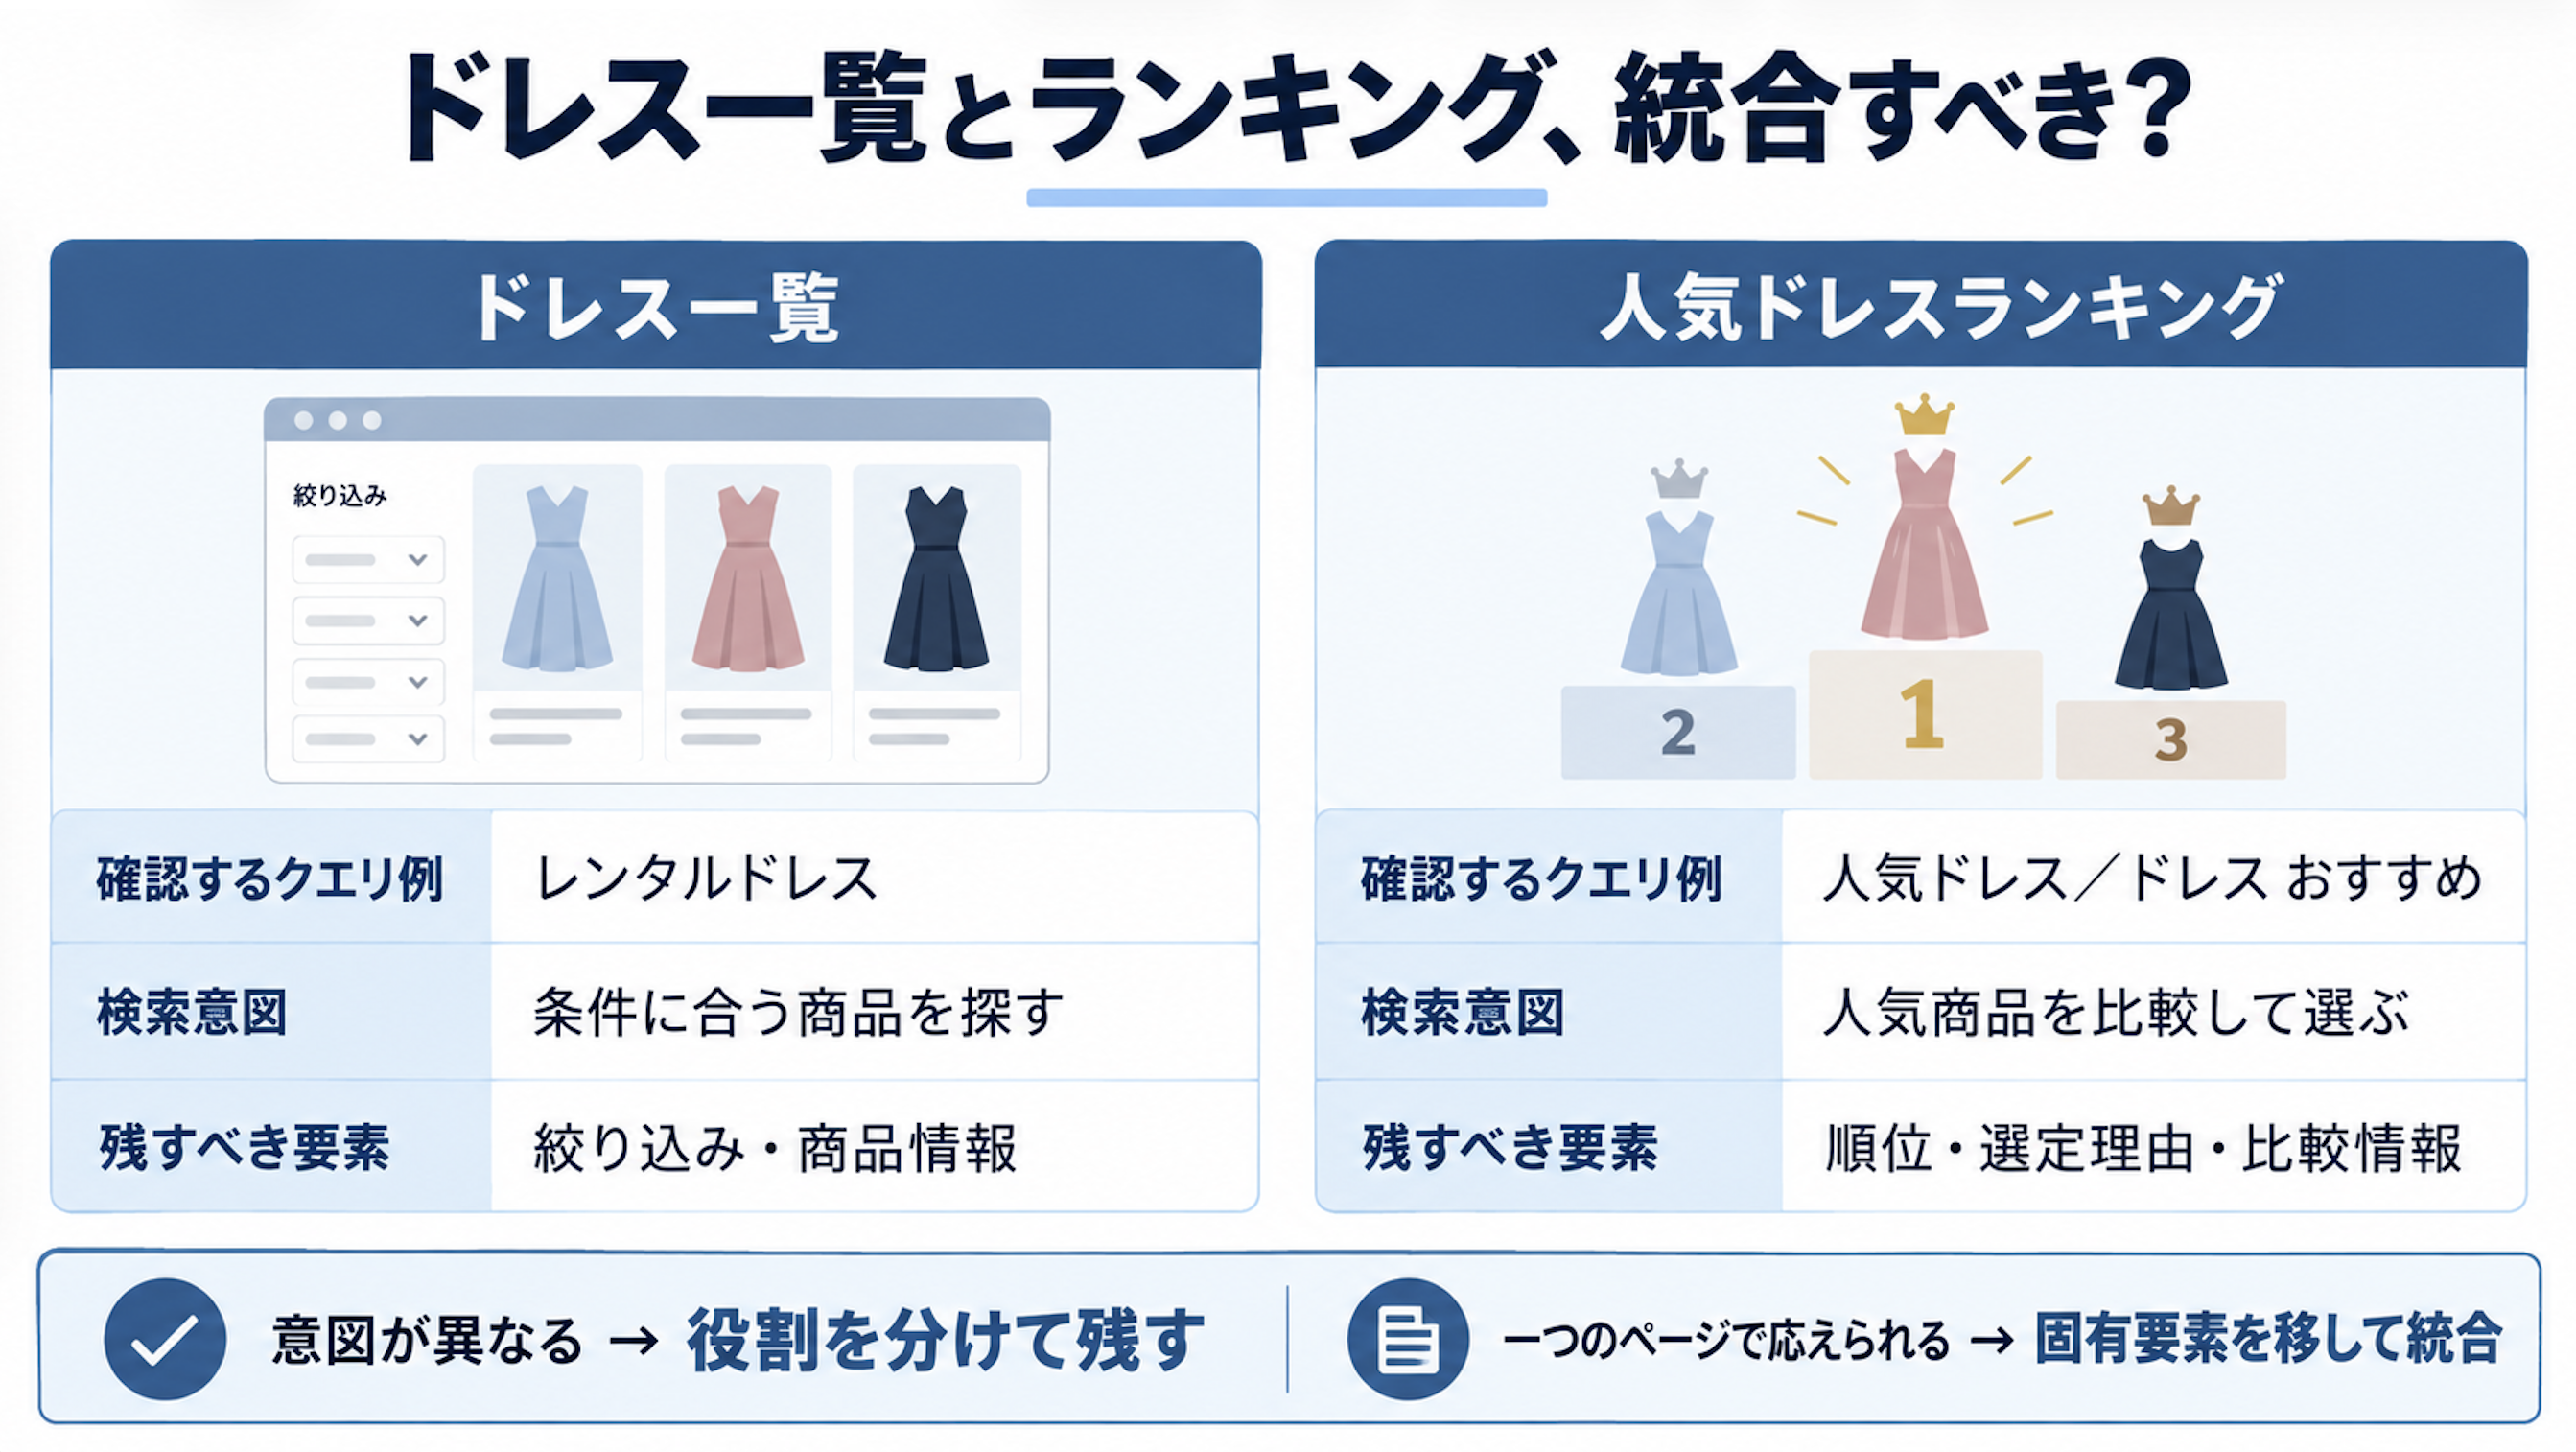
私なら次の順番で調べます。
①Search Consoleの検索パフォーマンスで、それぞれのURLを絞り、獲得クエリを出す。片方にしかないクエリ群があるか、表示回数・クリック数と合わせて見る。
②それぞれの主要クエリの検索結果を確認する。上位サイトが一覧とランキングを別ページで提供しているか、一つのページで応えているかを比べる。
③両者が別の意図を担うと判断できれば役割を分けて残す。一つのページで応える方が自然なら、統合先に何を移すかを決める。
クエリ一覧が多い場合は、URL別のデータをAIに渡し、「ページAだけが獲得しているクエリの種類」を分類する補助にも使えます。ただし、AIの分類と実際の検索結果・ページ内容は人が照合します。統合する場合も、片方だけが獲得していた検索意図と、その流入に貢献していた説明・商品選定・比較要素を統合先へ反映してから301リダイレクトを検討します。
重複コンテンツが発生する主な原因
意図的に重複コンテンツを作っているケースはほとんどなく、CMSの仕様やサイトリニューアル、SEO施策、広告運用など様々な要因で意図せず発生します。CMSが自動生成するパラメータURL、絞り込み・並び替え機能、開発環境・ステージングの公開、サイトリニューアル時の301漏れ、担当者変更による重複記事作成、サービス追加時の検索意図整理不足などが非常によくある原因です。
URLパラメータの付与
URLパラメータによる重複は、サイト規模によって影響度が異なります。同じ内容のURLが大量に生成されても、Googleが正規URLを選んでいるなら、評価がページ数に応じて機械的に分割されるわけではありません。一方、不要なURLの大量生成がクロールを増やしたり、意図しないURLが検索に残ったりする場合は、ページ群単位で対策を検討します。
パラメータ付きURLのクロールにクロールバジェットが消費され、重要ページのクロールやインデックスが遅れるケースもあります。ECサイトや求人サイトなど、数万~数百万ページ規模のサイトでは、絞り込み条件や並び替え、検索条件ごとにURLパラメータが生成され、放置するとSEOへ大きな影響を及ぼす可能性があります。
小規模サイトで問題にならないURL群もあれば、大規模サイトの絞り込みが重要ページのクロールに影響する場合もあります。対策を選ぶ前に、検索需要、URLの生成数、内部リンク、クロール状況を確認します。検索結果から外すnoindexと、クロール自体を抑えるrobots.txtは役割が異なるため、同じ目的で安易に併用しません。
Search Consoleの旧URLパラメータツールは廃止されています。現在は「ページ」レポートやURL検査でGoogleの選択を見たうえで、サイト側のURL生成、内部リンク、canonical、必要に応じたクロール制御を検討します。特にクロール負荷を減らしたい場合、noindexだけではGooglebotによる取得を止められません。
wwwあり・なしの重複
wwwあり・なし自体に順位への優位性はなく、SEO上の優劣はありません。重要なのはサイト全体でどちらか一方へ統一することです。既存サイトで既に多くの被リンクや評価が蓄積されている場合は、基本的には現在評価されているURLを維持することが推奨されます。
301を実装した直後に全URLの切り替えが完了するとは限りません。サイト規模やクロール状況に応じて移行の進み方が違うため、旧URLと新URLのインデックス状況、主要クエリの流入を継続して確認します。
HTTPとHTTPSの混在
HTTPSへ移行した際に適切な設定が行われていないと、HTTP版とHTTPS版の両方にアクセスでき、重複URLが残ることがあります。HTTP→HTTPSへの301リダイレクトが未設定、canonicalタグがHTTPのまま、XMLサイトマップにHTTP URLが残る、内部リンクがHTTPを参照するといった設定の不一致を確認します。
HTTP・HTTPSの両方が残っていても、Googleが正規URLを選び評価をまとめる場合があります。ただし、旧URLへの内部リンクやサイトマップなどのシグナルが混在すると、運用上の確認が難しくなります。HTTPSへの301、内部リンク、サイトマップ、canonicalを同じ方向に揃えてください。
PC版とスマートフォン版ページの重複
現在の新規サイトではレスポンシブデザインが主流のため、PC/スマートフォン版の重複問題が発生するケースは以前より大幅に減少しています。m.example.com、/sp/など別URLで運用しているサイトでは、現在でも重複コンテンツが発生するケースがあります。別URLで運用している場合は、PC→スマホへのalternate、スマホ→PCへのcanonical、不要なURLの301リダイレクトなど、Googleが推奨する設定になっているか確認することが重要です。
CMS・ECプラットフォームの自動生成
CMSやECプラットフォームでは、利便性を高めるために複数のURLが自動生成されることがあり、それが重複コンテンツの原因となるケースがあります。絞り込み・並び替えページ、タグページ・カテゴリページ、ページネーション、商品バリエーションURL、検索結果ページ、URLパラメータ付きURLなどが代表例です。
WordPress、Shopify、EC-CUBE、楽天市場など、プラットフォームごとに発生しやすい重複パターンは異なるため、自社で利用しているCMSの仕様を理解した上で対策を行うことが重要です。最も注意すべき点は、プラットフォームの標準設定だけで判断せず、実際に生成されるURLと検索に出したいページを照らし合わせることです。
ページタイプごとに「検索に出す/出さない」を決め、その方針に対してcanonical、内部リンク、サイトマップなどが矛盾なく設定されているか、実際のURLで確認することが重要です。プラットフォームがそう使うからという理由だけで、全てのページをインデックス対象にしてしまうと、意図しない重複が増える可能性があります。
サイト内検索結果ページ
サイト内検索結果ページでは、結果として表示される商品や記事の多くが共通するもしくは該当件数の少ない低品質な検索結果も生成されやすいため、重複コンテンツが発生しやすい傾向にあります。「シルバーアクセサリー」と「シルバーアクセ」で、URLは異なっても掲載内容がほぼ同じになる場合があります。検索結果が少ない、または0件の場合は、検索語だけが違う似たページも大量に生成されます。
サイト内検索結果ページを一律に重複と判断するのではなく、条件ごとに掲載内容が異なり、検索需要にも応えるページは、検索に出す価値があるか個別に判断が必要です。ユーザー向けの検索機能は維持しつつ、検索エンジンに見せたいURLを整理することが対策のポイントとなります。
需要があり、掲載内容も十分に異なる条件は、カテゴリページなどの安定したURLとして整備するといいでしょう。自由入力の検索語や並び替えなどで無数に生まれるURLは、検索結果に出す必要があるかを判断し、不要ならnoindexやクロール制御を使い分けます。ただし、noindexを使うURLをrobots.txtで同時にブロックすると、Googleがnoindexを確認できないため、検索に出したい条件まで一括で除外してはならないという点に注意が必要です。
意図しないコンテンツ複製
テンプレート上の説明文やフッターが複数ページで共通すること自体は珍しくありません。問題になるのは、ページの主要部分までほぼ同じで、独立した検索需要に応えていないケースです。商品や求人などの固有情報と、ページタイプの役割を確認します。
さらに、サイトリニューアルやシステム移行の過程で、古いコンテンツと新しいコンテンツが並存してしまったり、ページの複製機能を誤用して意図せず複数の同じページが生成されたりするケースもあります。これらはすべて「意図しない」複製ですが、検索エンジンにとっては意図の有無は関係なく、重複判定の対象となります。重要なのは定期的に自社サイトの構造を確認し、こうした複製が発生していないかを監視することです。
Googleは重複コンテンツをどう判定するのか
主要な内容が同じか、検索結果でどのURLが代表に選ばれるかを確認します。同じヘッダー・フッターやタイトルがあるだけで、ページ全体の内容まで同じとは限りません。Titleの重複は確認のきっかけになりますが、それ単独で「重複判定された」とは結論づけません。
Googleの判定基準と判定方法
完全一致はURLだけ違って本文が同じケースを指します。実質的に同じというのはタイトルや一部の文言は違っても、検索ユーザーに提供している情報やページの役割がほぼ同じケースです。実務では文章の一致だけで判断せず、どの検索意図をどのページで受けるべきか、実際にGoogleがどのURLを評価しているかまで見る必要があります。
記事同士に共通する説明があっても、異なる検索意図に応え、それぞれに固有の情報があるなら、別ページとして残す意味があります。共通部分の割合で機械的に決めず、各ページで読者が得られる答えを比べます。
コンテンツ一致率の基準
「何%以上なら重複」という一律の数字では判断していません。同じテンプレートを使う求人やECでも、求人内容や商品情報に独自性があり、別の検索需要に応えられるなら残す意味があります。逆に文面だけ変えても検索意図と提供価値が同じなら、ページの役割から見直す必要があります。テキストの一致率以外に文脈や意味的な類似度も考慮されるため、わずかな修正では対処できないケースが多いのです。
テキスト以外の判定対象(画像・構造・メタデータ)
同じ画像やページテンプレートを使っているだけで、ページ全体が重複と判断されるわけではありません。ECサイトで複数の商品ページに共通のロゴや説明欄があるのは自然なことです。確認したいのは、各ページの主要な内容に違いがあるかどうかということになります。商品画像も説明文もほぼ同じで、URLや見出しだけが異なる場合は、別ページとして提供する必要性や正規化の方針を見直す必要があります。
同じTitleは検索結果での表示やページの役割を点検するきっかけになります。一方、メタディスクリプションの重複だけをもって本文の重複とは判断しません。
正規URLの自動選択メカニズム
canonicalの指定だけを見て決めるわけではなく、内部リンクやリダイレクト、サイトマップ、実際のコンテンツの近さなど、複数のシグナルが一致しているかを確認します。「どのページを主役にしたいか」を決めてから、サイト内の導線と正規化の設定を揃えることが重要です。
canonicalタグを設定しても、意図した正規URLへの統一が進まない場合があります。指定元と指定先の内容が十分に近いか、内部リンクなどのシグナルが別URLを指していないかを確認します。求人サイトの広告LPでは、canonical指定後に一部のエリア系クエリが改善しても、LPのインデックスとビッグクエリの課題が残りました。施策を「効いた/効かない」の二択で判断せず、クエリ群ごとに経過を見ることが大切です。
重複コンテンツのSEOへの影響
SEOでまず問題になるのは、狙っているページとは別のURLが検索結果に表示されたり、同じ検索意図を狙うページ同士でランディングページが入れ替わったりすることです。Googleが重複URLのシグナルをまとめることもあるため、「評価がページ数で等分される」とは考えず、対象クエリで実際にどのURLが選ばれているかを確認します。
大規模サイトやデータベースサイトほど、同じパターンで大量ページに展開されるので、重複コンテンツの影響は大きくなりやすい傾向があります。
被リンク評価の分散による順位低下
同じ内容を複数のドメインに分けて公開すると、どのドメインを主な受け皿にするかという設計も必要になります。ただし、被リンクがあるだけで評価が単純に二分されるわけではありません。両サイトの役割や、どちらのURLが検索結果に表示されるかを確認します。
クロールバジェットの無駄遣い
クロールバジェットとは、Googleがそのサイトのクロールに使える・使いたいと判断する時間やリソースのことを指します。「1日○ページ」という固定の枠ではなく、サイトの応答状況や、Googleがページを確認する必要性などによって変わります。
ECサイトで、並び替えや絞り込みの組み合わせから、内容がほぼ同じURLが大量に生成された場合、Googleは各URLの内容を確認するためにアクセスするので、その分のクロールが発生します。こうしたURLへのアクセスが増えると、大規模サイトでは新しい商品ページや更新した重要ページの発見・再クロールが遅れる可能性があります。canonicalを設定しても重複URLのクロールが直ちにゼロになるわけではないため、まずは不要なURLが大量に生成・発見される仕組みを把握することが重要です。
大規模サイトでの深刻度
クロールバジェットは、とりわけ大量のURLを持つサイトで優先して検討します。無数の絞り込みURLへGooglebotがアクセスしている場合、新着商品や更新した重要ページの再クロールに影響していないかを確認します。順位が動くまでの期間はサイトごとに異なり、一律に「何日で悪影響が出る」とは言えません。
ユーザー体験の悪化
ユーザー向けには、検索結果に意図しないURLが表示され、クリック後に求める情報へ辿り着きにくくなることがあります。広告用LPが自然検索の受け皿になってしまう場合もあるため、検索結果に出すURLとユーザー向けに残すURLを分けて考えます。
検索結果表示の不安定性
同じクエリで表示URLが入れ替わる場合、まずそれぞれのページが異なる検索意図を受けているのかを調べます。もし本来はトップページで受けたい検索に広告LPが表示されているなら、ユーザーの着地先やCV導線に影響するかもしれません。ただし、表示URLの入れ替わりだけで「Googleが迷っている」「重複が順位低下の原因」とは断定できません。対象クエリ、表示URL、変更日、他の施策や検索結果の変動を合わせて見ます。
重複コンテンツはペナルティになるのか
Googleは「重複があれば必ずペナルティ」という考え方をしていません。通常の重複と、検索順位を操作するための大量コピーや無断転載は分けて考えているのです。URL違いで同じ内容が存在するだけで直ちに手動対策を受けるわけではありません。ただし、主力URLが選ばれず流入を逃したり、クロールが不要URLに使われたりする実害はあり得ます。
Googleの公式見解『ペナルティではない』
実務では「ペナルティかどうか」より、狙っているページが検索結果に出ているかを重視することが重要です。トップページで取りたい語句に広告LPが選ばれて順位が不安定になった事例は、手動対策の問題ではなく、ページの役割と正規化の問題として捉えるべきです。つまり、Googleのペナルティよりも、ビジネス上の機会損失の方が深刻なのです。
ペナルティが課される例外ケース
通常の技術的な重複と、検索順位を操作する目的で大量の低価値ページを作る行為は分けて考えます。後者はGoogleのスパムポリシーに触れる可能性がありますが、「重複したページがある」だけで自動的に手動対策を受けるわけではありません。
他サイトの記事を無断で複製する問題には、検索品質と著作権の両面があります。ただし、著作権侵害の有無やGoogleの対処をサイト全体の順位低下と直結させて説明することはできません。技術的な重複は、サイトの構造と正規URLの選択から調べます。
評価の分散と手動ペナルティの違い
「狙ったページが選ばれない状態」と手動対策は別の問題です。Search Consoleの「手動による対策」で通知の有無を確認し、あわせてURL検査や検索パフォーマンスから重要ページの選択状況を確認します。手動対策がなければ、順位低下の原因を別途調べます。
重複コンテンツの確認・チェック方法
複数のツールを組み合わせることが効率的です。まずはGoogle Search Consoleから始めることが基本となります。Search Consoleだけでは重複パターンの全体像を把握しきれない場合は、他のツールと組み合わせて確認します。
Google Search Consoleでの確認
まずSearch Consoleの「ページ」レポートで、重複に関係するインデックス未登録の理由を確認します。ユーザー指定の正規URLとGoogleが選んだ正規URLが異なるケースは、URL検査でも確かめます。表示される理由やURL数だけで異常と決めず、主力ページが登録・表示されているかを見ます。
「ページ」レポートで重複を確認する際は、重複がどんなパターンで発生しているのかを分類することが重要です。例えば、パラメータ付与なのか、それとも/有無なのか、それともルール的に判別できないものなのか、それぞれで対策方針が異なることがあるため、まずこのパターンを把握することが必須です。
重複があるから必ず同じ表示になるわけではなく、Googleが正規ページを選んだケース、canonicalの指定と選択が違うケースなど、インデックス登録レポートの理由は分かれます。URL検査でユーザー指定とGoogle選択の正規URLを見比べることが重要です。
「ページ」レポートとURL検査の見方
インデックス未登録のURLが増えても、意図した正規URLが登録されていれば、直ちに修正が必要とは限りません。逆に、件数が少なくても主力カテゴリや商品一覧が別URLへ正規化されているなら優先して調べます。私は「発生規模」と「重要ページへの影響・インデックス状態」をセットで見ます。重要キーワードに関わる同型の問題が数十・数百ページに広がり、不要なURLも検索に残っているなら、テンプレート単位の対応を優先します。正規URLだけが登録され、意図したページが流入を獲得できている群は、優先度を下げられます。
「Googleにより、ユーザーがマークしたページとは異なるページが正規ページとして選択されました」のような理由は、対象URLの例を取り、URL検査でユーザー指定とGoogle選択の正規URLを比べます。レポートの件数だけで結論を出さないことが大切です。
※実際の確認画面をもとに再構成したイメージ
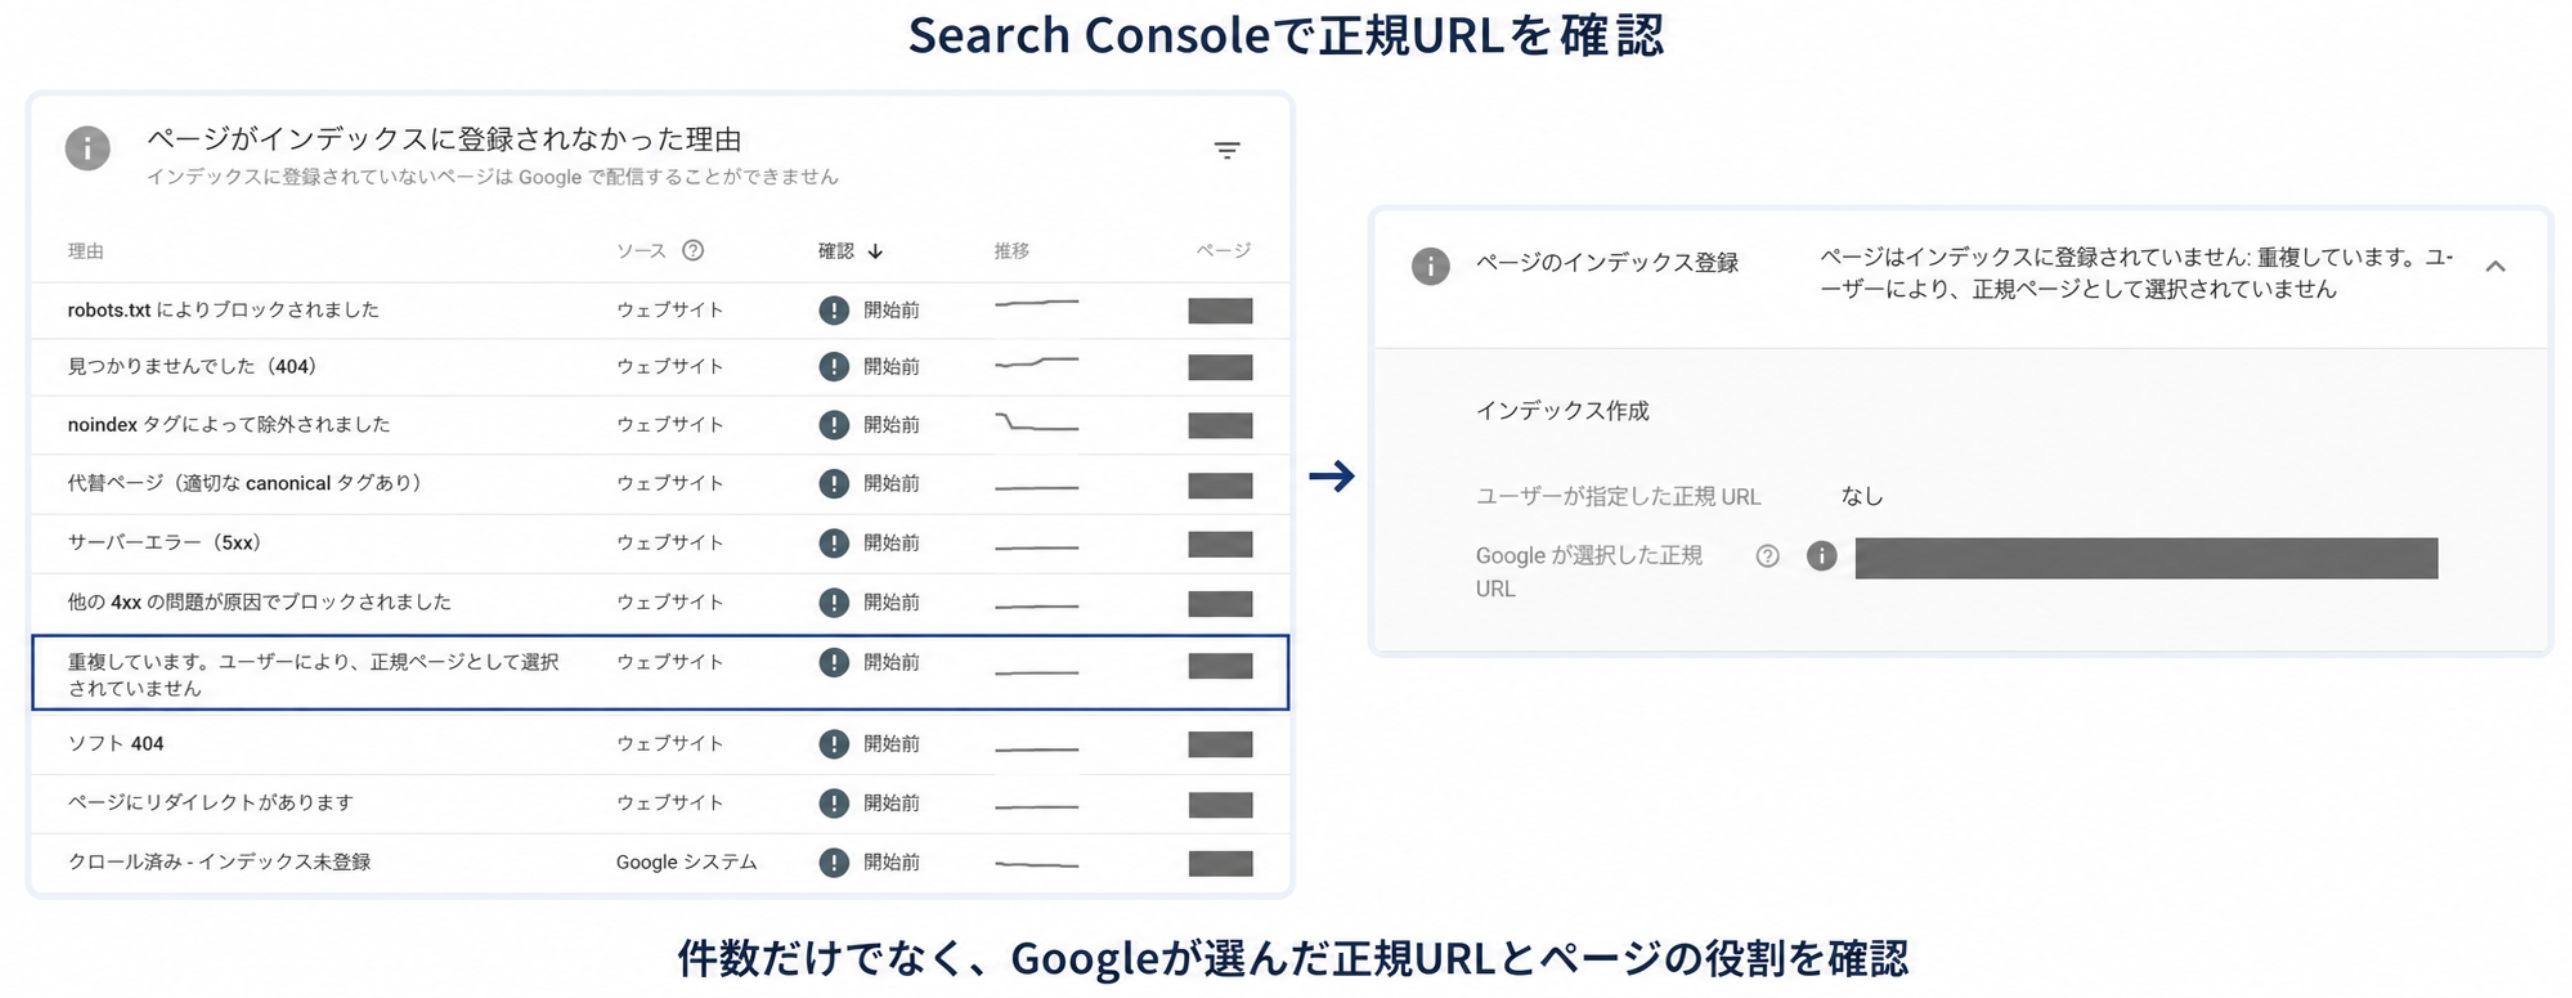
Search Consoleに載るURLはサイト内で生じる全URLの一覧ではなく、特にパラメータや絞り込みで大量生成されるサイトでは、URLの生成仕様、内部リンク、クロールの状況も合わせて確認が必要です。Search Consoleの表示が全てではなく、背景にある構造を理解することが対策の第一歩となります。
手動による対策の確認
Search Consoleの「セキュリティと手動による対策」に手動対策の通知があるかを確認します。通知がなければ「手動対策がある」とは言えませんが、流入低下の原因まで特定できるわけではありません。インデックス状況や検索クエリも分けて調べます。
site:検索による補助的な確認
site:検索で特定ディレクトリやURLの一部を指定し、検索結果に表示されるURLを補助的に確認できます。ただし、検索結果の件数や表示順はサイト内URLの完全な一覧ではありません。正規URLの判断には、Search ConsoleのURL検査を使います。
実際、アパレルECの新規提案時には、サイト内で見つけた絞り込みURLのソースを確認し、site: 検索でもそのURLが表示されることを手がかりに、ほかの生成パターンへ調査を広げました。ただし、site: に表示されたURLの件数をインデックス総数として使ったり、表示されないことを未登録の証拠にしたりはしません。重要URLの状態はURL検査で確認します。Googleも検索演算子は調査の補助にとどめ、URL検査を使うよう案内しています。
クロールツールによる自動チェック
Screaming Frogはサイト内のURLとメタ情報を大量に取得できるクロールツールです。URLパラメータの有無、タイトルの重複、メタディスクリプションの一致などを効率的に洗い出せます。特に数千ページ以上のサイトでは、手作業では把握できない重複パターンを発見するのに役立ちます。
ただし、Screaming Frogはサイト構造を技術的に分析するツールであり、Googleが実際に重複と判定しているかは別問題です。ツールの出力結果と、Search Consoleの実際の判定を照らし合わせることで、対策の精度が高まります。
外部転載の補助的なチェック
外部重複(転載)の確認には、重複コンテンツ検出ツールが役立ちます。CopyContentDetectorやCopyScapeなどを使えば、自社コンテンツが他ドメインにコピーされていないかを検索できます。ただし、検索結果に出ないコピーサイトは検出できず、これだけで網羅的に外部重複を把握することはできません。
最初はSearch ConsoleでGoogleが実際にどのURLを選び、重要ページの流入に何が起きているかを見る方針が効率的です。その上で、サイト内のURL生成や内部リンクをまとめて洗う必要があればクロールツールを使う、という順序が実務的です。ツールを増やすことより、Google側の現象とサイト側の原因をつなげることが重要です。
テキスト検索による手動チェック
本文中の特徴的な一文を引用符で囲って検索し、他ドメインに同じ文章が掲載されていないかを確認できます。ただし検索結果に出ない転載もあるので、これだけで網羅的に判断せず、自社ページのインデックスや流入への影響も見ることが必要です。
手動チェックで見落とされやすい重複パターンは、見た目が同じURLだけでなく、パラメータの順序違い、カテゴリや条件の掛け合わせ、広告LP、同一求人の複数掲載などです。ページを一枚ずつ読むより、URLが作られる仕組みとページタイプから洗う方が実務的です。
重複コンテンツ対策の3大手法と使い分け
導入順を固定するのではなく、まず残すべきURLと各ページの役割を決めることが重要です。同一コンテンツを別URLでも表示する必要があればcanonical、旧URLを使わなくてよければ301、広告LPのようにユーザーには必要でも検索結果には出したくなければnoindexを検討します。複数の手法を組み合わせて使う場合は、URL群ごとに目的を分けて設計することが大切です。
移転した旧URLは301、残す必要がある実質同一の別URLはcanonical、検索対象から外すページはnoindexという考え方が理想的です。同じURLでcanonicalとnoindexを安易に重ねず、内部リンクやサイトマップも正規URLと整合させることが重要です。
Canonicalタグによる対策
canonicalは正規URLを指定する強いシグナルですが、必ず採用される命令ではありません。設定後はSearch ConsoleのURL検査でGoogleが選んだ正規URLを確認します。違うURLが選ばれるなら、ページ内容、内部リンク、リダイレクト、サイトマップの整合性を見直します。
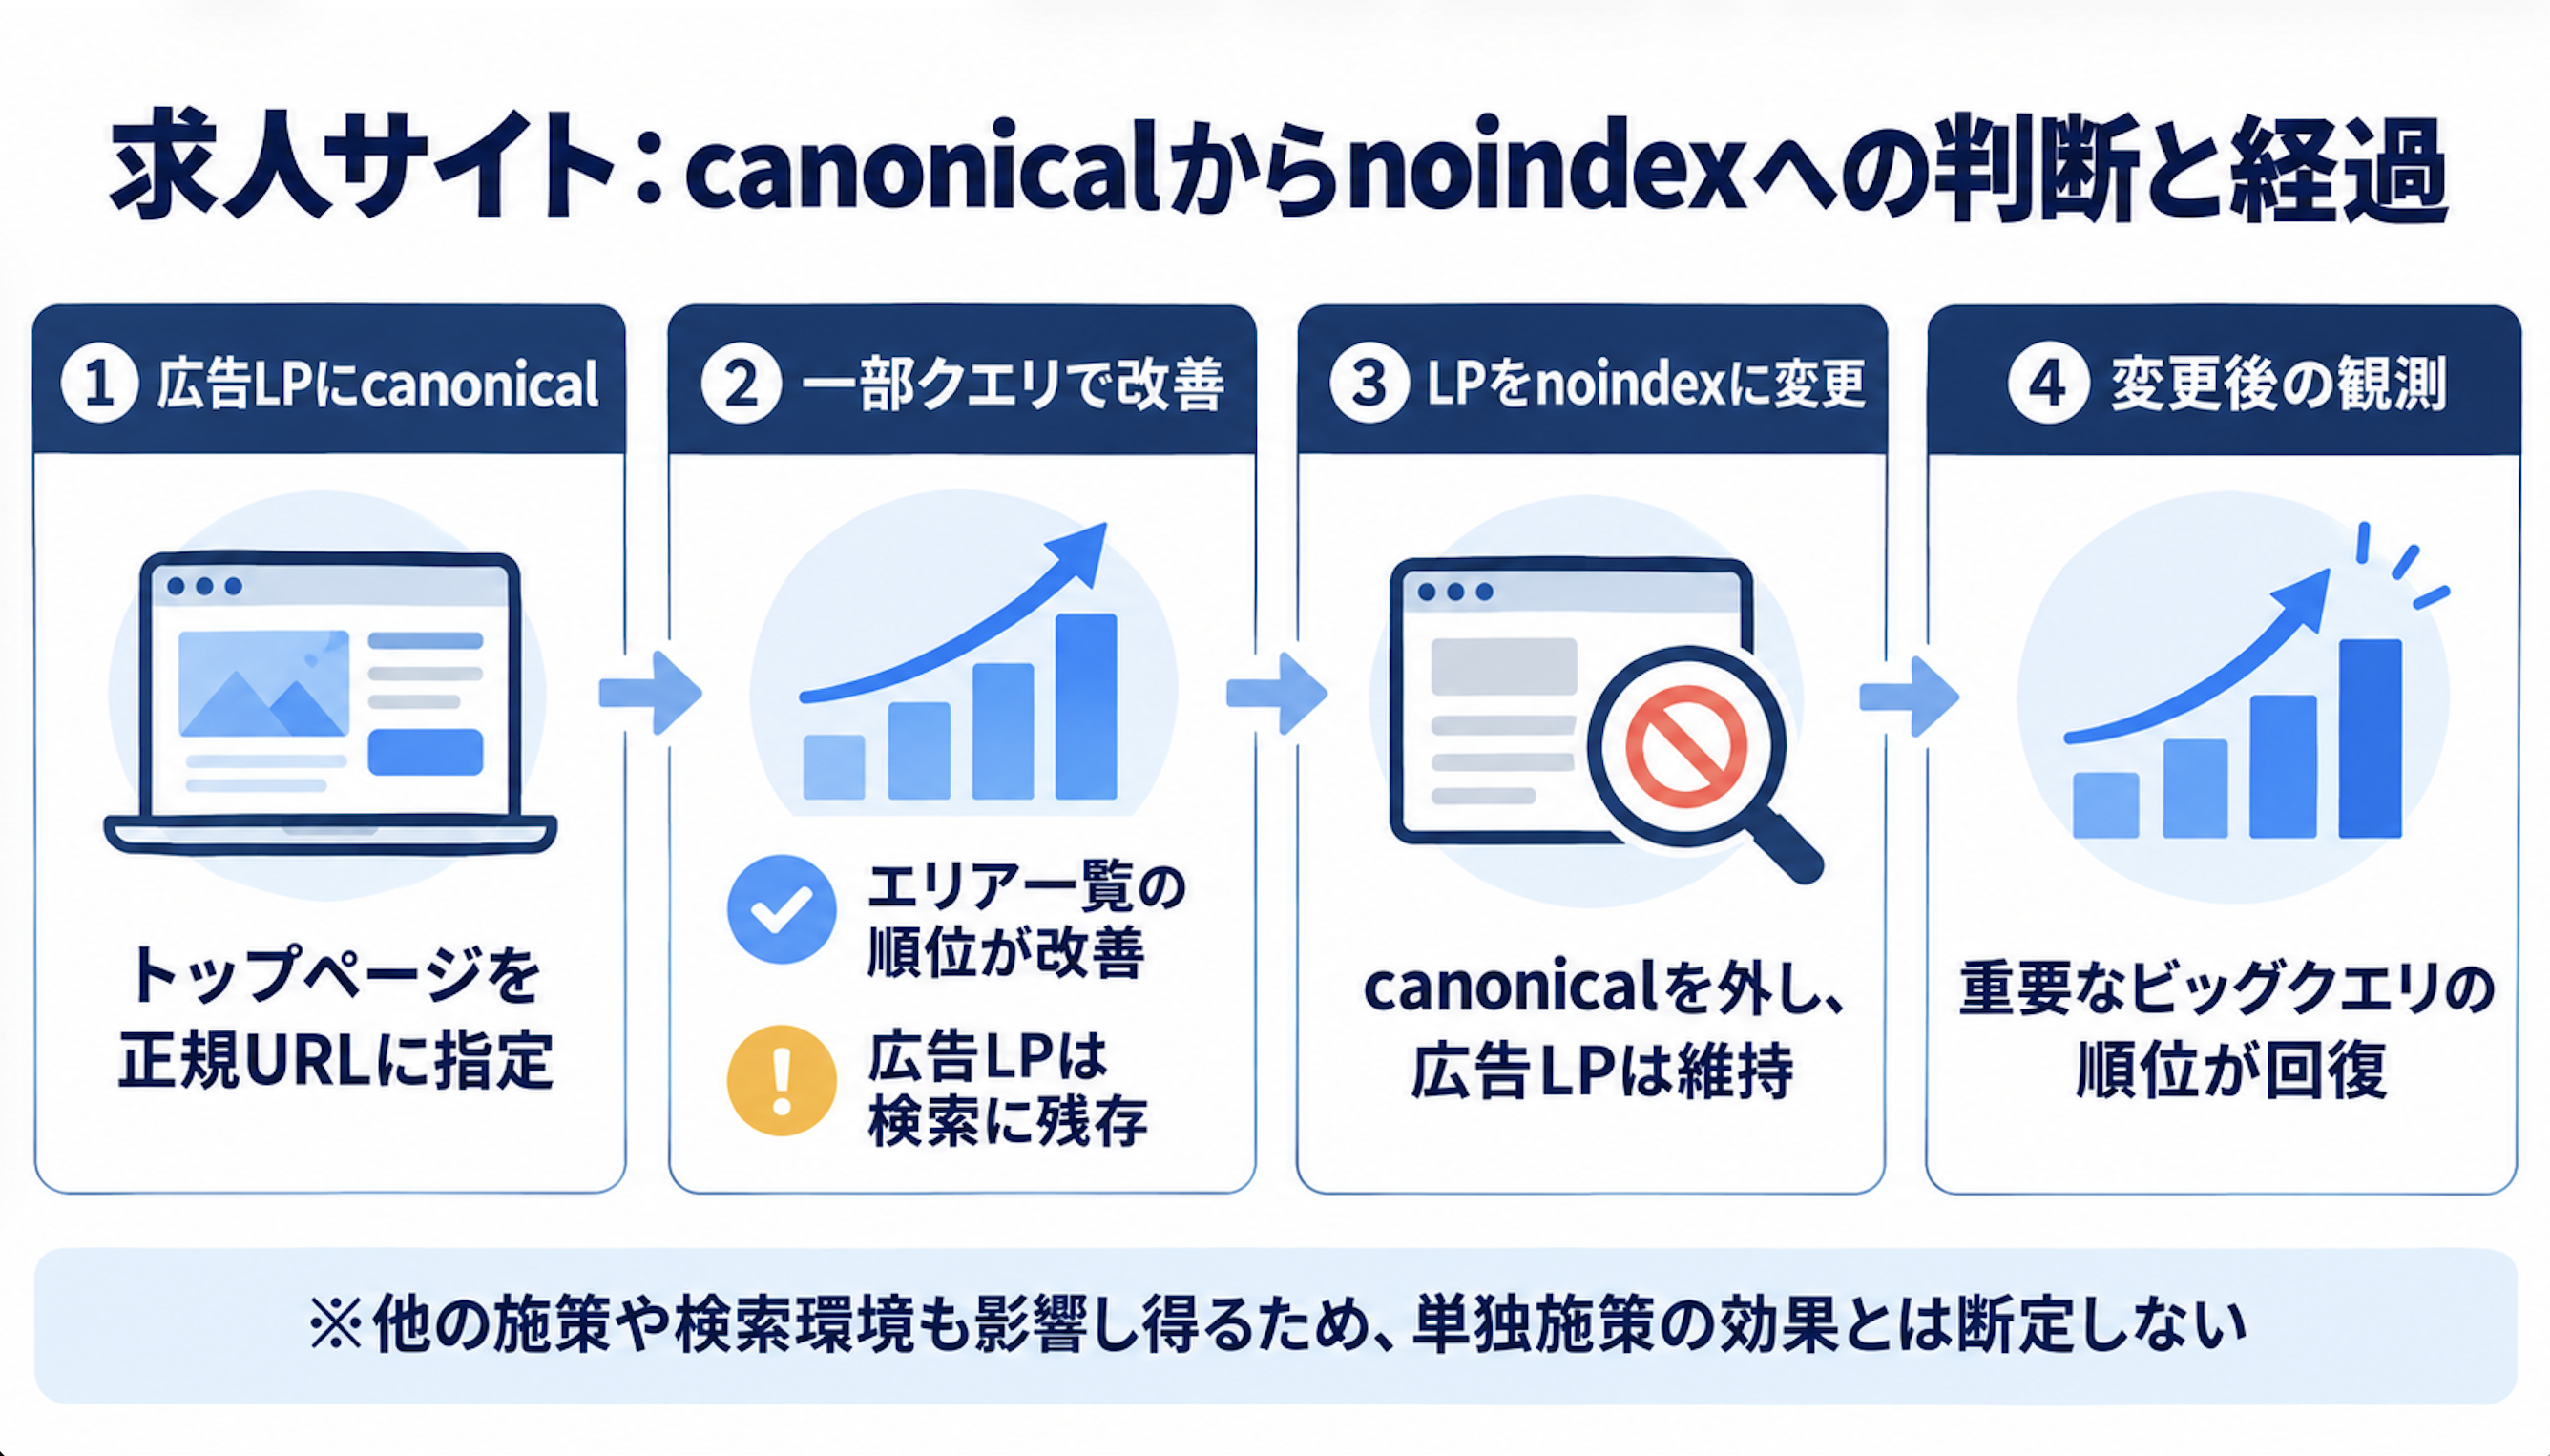
私が支援した求人サイトでは、広告LPからトップページへのcanonicalを指定した後、本来のエリア一覧が対象クエリの着地先として表示され、順位も改善しました。一方、広告LPは検索インデックスに残り、最重要のビッグクエリは回復しませんでした。「canonicalが全く効かなかった」とは言えない状態です。ほかの要因も確認したうえで、広告には必要でも自然検索には出さないというLPの役割に合わせ、canonicalを外してnoindexへ変更しました。その後、ビッグクエリの順位回復が見られました。両施策は目的が異なり、この結果だけでnoindexが評価をトップページへ引き継いだとは言えません。
設定方法と実装の注意点
canonicalとnoindexは目的が異なります。同じ重複URLで評価の統合とインデックス除外を同時に狙う設定は避け、どちらの目的を優先するかを決めてください。別ドメインのURLへcanonicalを指定する場合は、掲載元・掲載先の運営者間で公開と正規化の方針が一致しているかも確認します。
その上で対象ページの内容が十分近いか、指定先が正常に閲覧・インデックス可能か、canonicalが自己矛盾や循環を起こしていないかを見ることが大切です。公開後はURL検査でGoogleが実際に選んだ正規URLを確認することが重要です。
canonicalで解消しきれないケースの対処
「こちらが選ばせたいURL」と「Googleが選んだURL」のどちらがユーザーの検索意図に合うかを確認することから始めます。意図しないURLが選ばれているなら、コンテンツの重複度だけでなく、内部リンク、サイトマップ、canonicalやリダイレクトの整合性を確認が必要です。重要ページへの評価が集まる構造に直すことが必要になります。
Canonicalタグから301リダイレクトへの切り替えは、使わない旧URLを301に切り替えるとユーザーもクローラーも移動先へ直接案内でき、正規化のシグナルも明確になります。ただし、広告LPなど旧URLを使い続ける必要があるページはリダイレクトできないため、まず事業上そのURLを残す必要があるかで判断することが重要です。
301リダイレクトによる対策
リダイレクト実装中に検索結果が不安定になる事例があります。大規模サイトでURLを切り替えると、Googleが旧URLと新URLを再クロールして正規URLを認識し直す間、表示URLや順位が揺れることがあります。移行前後で対象ページ群のインデックスと検索流入を追い、想定外の下落と一時的な切り替わりを分けて見ることが重要です。
設定方法と期待できる効果
301リダイレクトを誤って設定した場合のリスクは、異なる検索意図のページを同じURLにまとめると、それぞれが獲得していた検索需要を失う可能性があることです。ループ、連鎖、無関係なページへの転送、内部リンクの旧URL放置も避けるべき落とし穴です。URL対応表とページの役割を先に整理してから実装することが重要です。
大量のURLをリダイレクトする場合は、数が多いから必ず段階的とは考えず、テンプレート単位で影響範囲や検索需要を確認し、重要なURL群から検証して広げることが可能です。一括変更でも、対応表、内部リンク、サイトマップ、切り戻し方法を用意できるかが判断基準となります。
noindexタグによる対策
ページを完全に削除せず、noindexを設定するメリットは、検索結果には出さず、広告やサイト内導線のためにページを残せることです。求人サイトの広告LPは広告集客上必要だったため、削除も301もせずnoindexを選びました。変更後にトップページで狙うビッグクエリが1位へ戻りましたが、その変化をnoindex単独の効果とは断定していません。
noindexを使うべき場面
サイト内検索結果ページやタグページなど、削除されたくないページに適用する場合、SEOへの悪影響があるかどうかは確認が必要です。そのページ群に検索需要や流入があるかを見ることが大切です。サイト内検索結果やタグページを全部同じルールで外すのではなく、独自の需要に応える一覧は残し、内容が薄いものや主力ページと競合するものを制御することが重要です。
求人サイトではエリア・職種・条件の組み合わせを一律に扱わず、求人件数や需要を踏まえて設計したケースがあります。検索需要のあるページまで一律にnoindexにすると、ビジネスチャンスを逃すことになるため、個別の判断が欠かせません。
手法ごとの選択基準フレームワーク
先に「そのURLが検索結果に必要か」「ユーザーが引き続きアクセスする必要があるか」「移転先に引き継ぐ内容・意図があるか」を決めます。
判断する状態 | 検討する対応 | 注意点 |
|---|---|---|
固有の検索意図と掲載内容があり、別ページとして獲得したい | 残して役割を明確にする | 固有クエリ、競合の検索結果、掲載件数を確認 |
内容を統合し、旧URLを使わなくなる | 内容を移したうえで301 | 旧ページ固有の獲得クエリを失わない設計にする |
内容が実質同じで、別URLもユーザー向けに維持する | canonical | Googleへの正規URLのヒントであり、採用を保証しない |
ページは広告・サイト内導線に必要だが、検索結果には出さない | noindex | 正規URLへの評価統合を目的に選ばない。Googleがクロールできる状態で指定する |
結果が0件、または検索価値のないURLが大量生成される | 生成・導線・インデックス・クロール方針をページ群ごとに見直す | noindexだけではクロール負荷を解消できない |
Googleは、同一サイト内での正規URL選択を防ぐためにnoindexを使うことを推奨していません。求人サイトでnoindexを選んだのは、広告LP自体を検索結果から除外する目的があったためです。並び替えURL、旧URL、独立した需要があるカテゴリにまで同じ設定を適用しないことが重要です。
URLパラメータが原因の重複対策
動的パラメータの制御方法
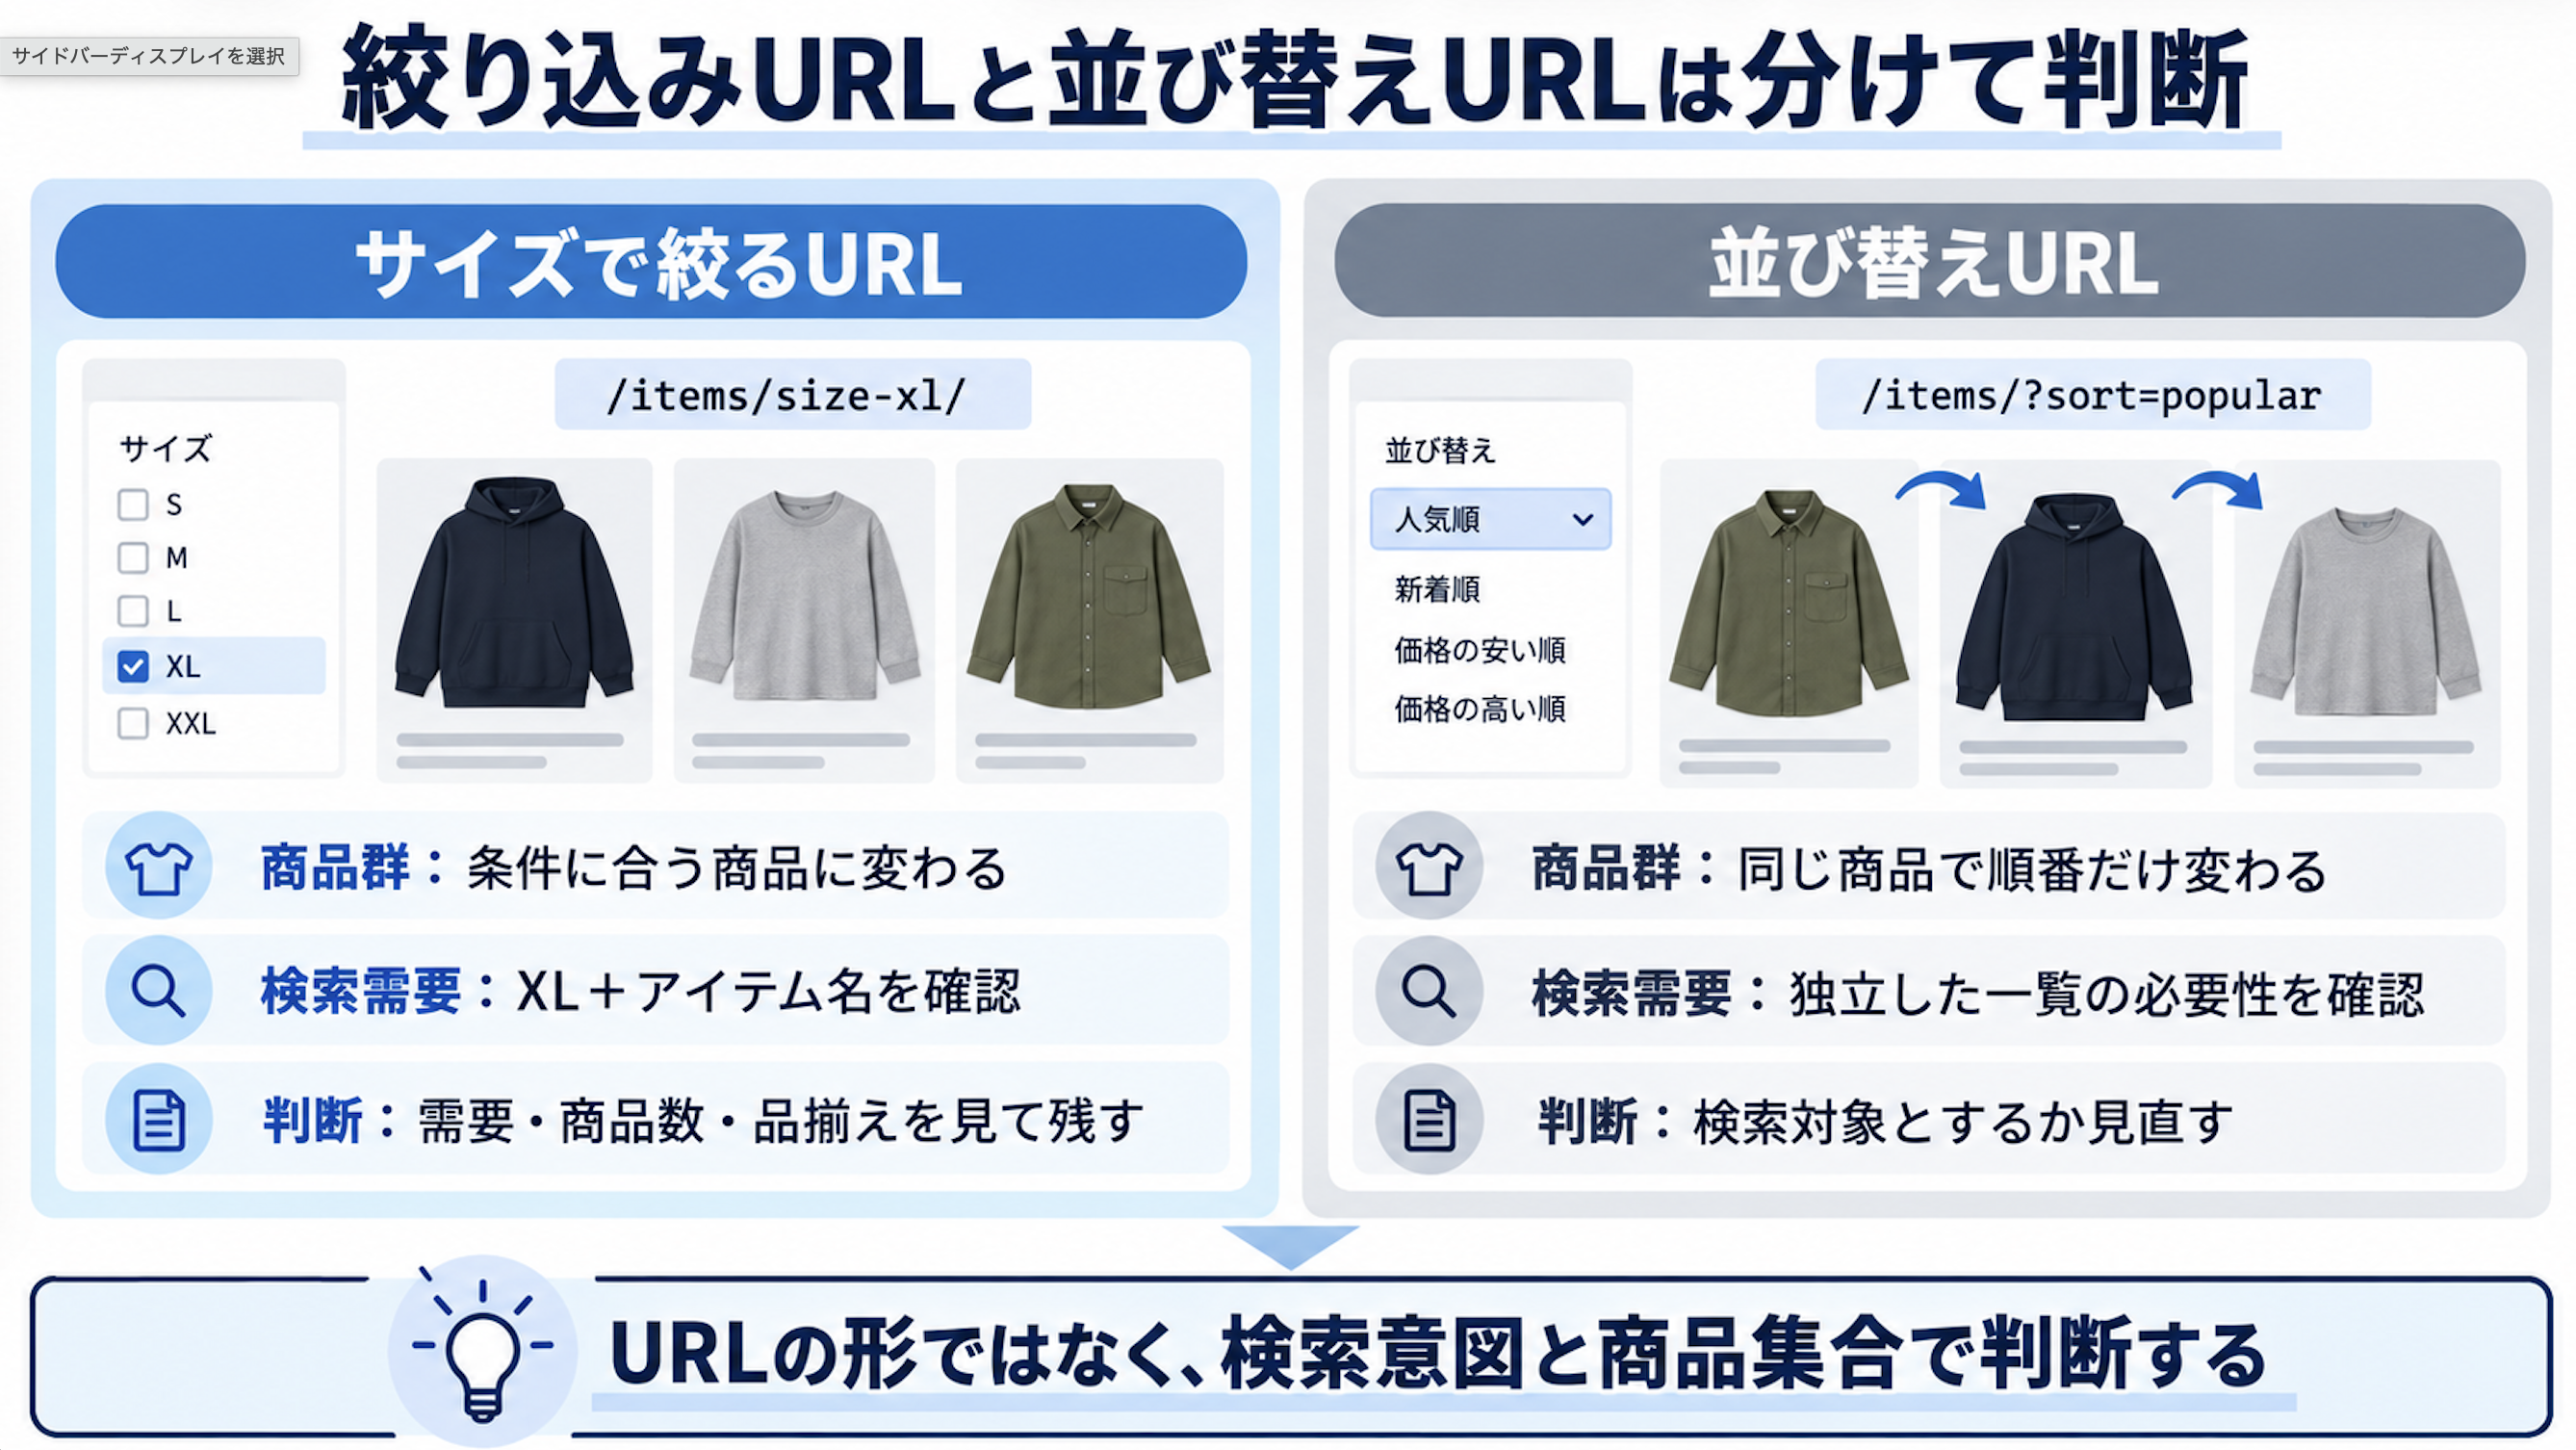
動的パラメータの種類によって対策方法は大きく変わります。計測用の値だけなら同じ本文を別URLで見せる理由があるか、ソートや絞り込みなら結果の内容と検索需要が変わるかを見ることが大切です。ECや求人の掛け合わせでは、検索需要と掲載件数が十分なページを選ぶなど、パラメータ名ではなく生成されるページの役割で決めることが重要です。大きいサイズを強みとするアパレルECなら、XL+アイテム名、3L+アイテム名に需要があり、商品が十分に並ぶ場合もあります。「サイズで絞り込むURLだから全部noindex」とは決められません。
ソートは表示順だけが変わるなら主力一覧へ正規化する方向で見ます。絞り込みは「地域×職種」など別の検索需要に応えることがあるので、検索量や掲載件数を確認して残すページを選ぶことが大切です。結婚式場比較サイトでは、不要な掛け合わせを制御しつつ、需要がある一覧を新設しました。
順序が違うだけで同じ結果を返すURLも、クロール上は別URLとして発見され得るため、サイト側でパラメータの並びを統一できるか確認し、内部リンクや正規URLの指定がばらけないようにすることが重要です。
Search Consoleの旧パラメータ機能と現在の対処
Search Consoleの旧URLパラメータ設定機能を前提にした運用はしていません。現在はサイト側で、不要な別URLを発生させない設計、正規URLへの内部リンク、必要に応じたcanonicalや301を組み合わせます。別URLを完全に廃止できるなら301を検討することが基本的なアプローチです。
wwwあり・なしの正規化対策
優先するドメイン形式の決定
wwwの有無自体に優劣はなく、wwwがあるかないかだけでSEO上の有利不利は決まりません。重要なのは両方に評価を分散させず、どちらか一方を正規URLとして一貫して使うことです。既存の被リンク、現在評価されているURL、サービスの運用方針を踏まえて正規ホストを決め、サイト内リンクとサイトマップを揃えることが基本です。
決定後に企業の方針が変わった場合、切り替えはできますが、影響URL が多いほどリダイレクト、内部リンク、サイトマップ、計測の更新が必要になります。企業の方針だけで頻繁に変えず、将来のサブドメイン運用やシステム構成まで踏まえて決めることが重要です。既に逆の設定でインデックスされている場合の切り替え手順は、先に正規ホストを決め、旧URLから新URLへの301、内部リンク、canonical、サイトマップを同じ方向に揃えます。
公開後はSearch ConsoleでGoogleが選んだ正規URLと主要ページの流入を確認することが大切です。大規模サイトでは切り替わりに時間がかかるため、すぐに成功・失敗を決めつけないことが重要です。
301リダイレクトまたはcanonicalによる統一
wwwの統一で片方のURLを使わないなら、301リダイレクトで一本化する方針が効果的です。canonicalだけではユーザーもクローラーも両ホストへアクセスできる状態が残るため、サーバー設定と内部リンクも合わせて整理が必要です。サーバー側の301を設定したら、HTMLのcanonicalも転送先を指すよう揃え、内部リンクとサイトマップを正規ホストで出すことが重要です。両方を必ず別々に足すというより、サイトが示す正規URLに矛盾がない状態を作ることが最優先です。
CMS・ECサイト・求人サイトなど形態別対策
プラットフォーム名で一律の答えは出せません。Shopifyの支援では、URL階層を自由に変えにくい制約を踏まえ、パンくずと内部リンクでカテゴリの関係を伝え、コレクションの正規化やインデックス制御を整理しました。求人DBでは、地域・職種・条件の生成ルールと掲載終了求人の扱いを先に設計することが大切です。
プラットフォームの自動生成機能を無効化することは、SEO上推奨されない場合が多いです。自動生成を一律に止めるのではなく、検索需要に応えるページまで消えないかを確認することが重要です。ECのコレクションや求人の掛け合わせは、ページ群ごとに件数、固有情報、流入を見て、残す・正規化する・検索対象から外すを分けることが実務的です。
WordPressでの重複対策
WordPressのタグページやカテゴリーページの重複をどう対処するかは、検索意図の異なる一覧として価値があるかを確認することから始まります。カテゴリやタグを全部noindexにするのではなく、個別に判断が必要です。同じ記事が並ぶだけで主力カテゴリと競合するタグなら、統合やインデックス制御を検討します。残すページには固有の役割と適切な内部リンクを用意することが重要です。
ECサイト(Shopify・WooCommerceなど)での対策
ECプラットフォームの仕様上、避けられない重複にはどう対応するかが課題です。仕様上URLを一本にできなくても、どの一覧・商品詳細に評価を集めるかは設計できます。Shopifyの支援では、コレクションの役割を検索需要と既存流入から選別し、正規化、インデックス制御、パンくず、内部リンクを組み合わせました。システム側の制約はエンジニアとすり合わせることが必要です。
商品カテゴリの重複ページ対策
同じ商品が複数カテゴリから辿れること自体より、商品詳細に複数の異なるURLが発生するかを確認が重要です。URLが分かれるなら主となる商品URLを決めて正規化し、カテゴリ一覧はそれぞれの検索需要に応えられるなら残します。親子カテゴリの双方に商品が表示されるだけなら、直ちに重複ページとは判断しないことが大切です。各一覧が別の検索意図を満たすか、掲載内容がほぼ同じで競合していないかを見て、カテゴリの役割や内部リンクを調整することが重要です。
ソート・フィルター機能による重複対策
価格順・評価順などのソート機能で生成されるURLは、商品の集合が同じで並びだけが違う場合が多いので、検索対象とする一覧URLを決め、ソートURLが無制限に増えないよう設計することが大切です。絞り込みで独立した検索需要が生まれる場合は別扱いにします。ユーザーに必要な絞り込みや広告LPは維持しつつ、検索エンジンに評価させるURLを選ぶことが重要です。
大規模ECでは検索需要のあるカテゴリを残し、需要の薄いコレクションは制御するなど、使い勝手と検索対象の範囲を分けて設計することが理想的です。ユーザービリティを損なわずに重複を避けることは十分に可能です。
求人サイト・ディレクトリサイトでの対策
同じ求人に複数のURLができるのか、それとも一つの詳細ページへ複数の一覧からリンクしているだけなのかを先に分けることが重要です。主婦向け求人DBの立ち上げ支援では、同一企業の類似求人や掲載終了求人を含めて詳細ページの運用ルールを設計しました。地域・職種の一覧は検索需要と掲載件数を見て残す範囲を決めることが大切です。
大規模DBサイトでの対策
膨大な動的コンテンツを持つサイトで重複制御の優先順位をどう決めるかは、まず事業に重要な検索市場とページタイプを決めることから始まります。その後、重要ページへのクロールや内部リンクを阻害する大量の不要URLを特定し、テンプレート単位で対処することが効率的です。
50万~100万URL規模の結婚式場比較サイトでは、正規の地域別一覧と同じ会場を返すサイト内検索ディレクトリや、新しいURLと検索意図が重なる旧ディレクトリが残っていました。URLの数を減らすだけではなく、どのディレクトリを検索上の受け皿にするかを定め、重複するページ群を整理しました。検索意図の異なる一覧は残し、新しい需要の受け皿も設計しました。Google Search Consoleだけでなく他のツールの活用が必須とまでは言えないですが、大量の動的URLがある場合はSearch Consoleだけでは生成ルールや全URLを把握しきれません。まずGoogleが何を選んでいるかを確認し、必要に応じてクロール結果やサイト側のURL一覧、アクセスログ、検索需要を突き合わせることが重要です。
外部重複・無断転載への対応
他社によるコンテンツ無断転載の対策
自社ページが検索結果に残り、流入に影響しているかを確認することが優先です。無断転載先に削除を依頼し、応じてもらえず権利侵害に当たる場合はGoogleへの著作権侵害の申告も検討する価値があります。転載を見つけた事実だけで慌てず、影響と権利関係を確認してから進めることが大切です。焦ると無理な法的主張をして逆に信用を失う可能性もあります。
削除依頼とGoogleへの申告
転載先への削除依頼で解決しない場合、権利関係を確認したうえでGoogleの著作権侵害に関する法的削除申請窓口への申告を検討します。Search Consoleの「手動による対策」は、自社サイトに対する措置を確認する場所であり、他サイトの著作権侵害を申告する窓口ではありません。Google検索結果からの削除と、掲載サイトからの削除も別の手続きです。
重複コンテンツ対策の優先度の決め方
膨大な重複が見つかった場合、まず発生パターンごとにまとめます。そのうえで①重要キーワードや売上につながるページへの影響、②同じ問題が発生するURL数、③本来不要なURLが検索インデックスに残っているか、を見ます。主力ページと競合するパターンが数十・数百URLに広がるなら優先度が高くなります。逆に、件数が多くても意図した正規ページが選ばれ、重要な流入に影響が見えない群は、ほかの課題より後に回せます。
限られたリソースで最大のSEO効果を得るためには、検索需要と事業貢献が大きいページ群から着手し、テンプレート変更で多数のURLに効く施策を優先することが効果的です。ただし一律のnoindexやcanonicalで有効なロングテールを失わないよう、検索意図の違いと実装難易度も併せて評価することが重要です。
影響度×実装難易度マトリクス
影響が大きく実装が容易なら、重要URLへ向かう内部リンクやcanonicalの矛盾をまず直すことから始めます。影響が大きく難しいものは、ECの大量の絞り込みや求人DBの生成・indexルールの再設計など、時間と専門知識が必要になります。影響が小さいものは緊急度を下げますが、テンプレート修正でまとめて直せるなら実施を検討する価値があります。
影響度と実装難易度の評価には仮説の部分がありますが、主観だけで決めてはいけません。検索需要、既存流入、CV、対象URL数、現在の正規URLの選択、実装工数を並べて判断することが重要です。実装後に順位やインデックスが想定と違えば、優先順位も更新することを忘れずに。
優先的に対処すべき重複コンテンツ
検索流入が見込める重複ページから優先的に対処するのが基本ですが、今ある流入だけを見ると、新たに受け皿を作るべき検索需要を見落とす可能性があります。結婚式場比較サイトでは、不要な掛け合わせを制御しながら、需要があるのにページがないという領域には新しい一覧も設計しました。
ページランク(被リンク数)と検索流入のどちらを優先度の指標とするかは、どちらか一つに絞らないことが大切です。被リンクがあるURLでも、別の検索意図を満たすページへ無理に統合すると機会を失います。対象語句の需要、流入、CV、リンク、ページの役割を見て、最終的にどこへ評価を集めるべきか決めることが重要です。
重複コンテンツ対策を含む改善事例
以下は私が支援した案件での判断過程です。掲載した順位・流入の変化には、同時期のほかの施策や検索環境も影響し得るため、重複対策単独の効果とは扱っていません。
求人サイト:canonicalで見えた改善と、残った課題
業界特化型求人サイトでは、重要なビッグクエリで狙うページの順位が下がり、広告LPと本来の着地先の役割の重なりが疑われました。重複を原因と決め打ちせず、表示URLと対象クエリを追いながら対応しました。
まず、LPからトップページへcanonicalを指定しました。変更後、本来のエリア一覧が該当クエリの着地先として表示されるようになり、それらの順位は改善しました。この時点ではcanonicalの継続も選択肢でした。ただし、LPのURLは検索インデックスに残り、最重要のビッグクエリはまだ回復していませんでした。
LPを広告で使い続ける必要があるため、トップページへの301は適しません。ほかの要因も並行して確認したうえで、LPを自然検索の対象から外す方針に変更し、canonicalを外してnoindexを設定しました。その後、ビッグクエリの順位回復が見られ、1位に戻りました。canonicalの段階で改善した領域と、noindexへの変更後に改善した領域を分けて評価したことが、この事例のポイントです。noindexがLPの評価をトップページへ移したと断定できる事例ではありません。
大規模アパレルEC:絞り込みを全部消さず、残す掛け合わせを設計
リニューアル後に順位が下がったアパレルECの新規提案にあたり、サイト構造を調査しました。色・サイズ・素材で絞り込むURLと、「新しい順」「人気順」などの並び替えURLが生成されていました。絞り込みURLを実際に開き、ソース上のインデックス制御を調べ、site: 検索でも表示されるURLを手がかりに、同じ仕様のURL群へ調査を広げました。重要なURLの登録状態はURL検査などで確認する必要があります。
制御方針を決める際は、発生URL数が多いパターンから調べつつ、すべてを一括でnoindexにしませんでした。たとえば大きいサイズが強みのサイトでは「XL+アイテム名」「3L+アイテム名」に検索需要があり、商品件数も確保できる可能性があります。検索需要、掲載商品数、独自の品揃え、既存の流入を見て、残す条件と制御する条件の境界を決めました。並び替えのように商品集合が変わらないURLは、絞り込みと分けて判断します。
重複・パラメータへの対応と並行して、内部リンク、重要ページの情報やクロール導線も改善しました。支援期間中、オーガニック流入は約2倍、EC売上は前年比120%となりました。これらは複数施策を合わせた期間の成果であり、重複URLの制御だけによる増分ではありません。
結婚式場比較サイト:検索結果ページと旧ディレクトリを整理
50万~100万URL規模の結婚式場比較サイトでは、正規の「横浜の結婚式場一覧」と同じ会場群を返すサイト内検索結果のディレクトリが存在しました。検索上で担う役割が重なるため、検索結果を無数に生成する側のディレクトリを整理しました。さらに、新しいページと検索意図が重複する旧ディレクトリが数千~数万URL規模で残っていたため、ページ群単位で制御しました。
このほか、条件に該当する会場が0件のページも大量にインデックスされる仕様だったため、検索対象から外す方針を設けました。旧ページの一部は302リダイレクトで残っていたため、恒久的な移転先があるURLは301へ修正しました。302というコードだけで旧URLが残る原因を断定せず、各URLの転送先、インデックス状態、内部リンクも確認します。
不要URLを整理する一方、検索需要があるのに受け皿がない領域には新しい一覧を設計し、内部リンクも見直しました。主要エリアのキーワードが15位から2位へ改善したのは、こうした複数の変更を行った期間の結果です。私が目指したのは、売上につながる重要ページを頂点とするサイト内の構造を、Googleに伝え直すことでした。
重複コンテンツ対策のよくある誤解
クライアントが最も誤解しやすいのは「重複があれば必ずペナルティ」と「canonicalを入れれば必ず統一される」という2つです。実際には、どのURLが検索結果に選ばれ、どのページが検索意図を受けるべきかを確認してから、ページの用途に合わせて対処を選ぶことが重要です。
誤解に基づいた対策によって、検索需要のある一覧まで一律にnoindexにすると、ロングテールの受け皿を失う可能性があります。内容や検索意図の異なるページを無理にcanonicalで束ねても採用されないことがあります。重要なのはURL数を減らすことではなく、評価を集めるべきページを明確にすることです。
『重複コンテンツ=自動でペナルティ』という誤解
「重複があるから手動対策を受けたはずだ」と考えると、原因を調べずに有効なページまで消す可能性があります。まずSearch Consoleで手動対策の有無と、Googleが選んだ正規URL、対象ページの順位・流入を別々に確認することが重要です。
実務では「ペナルティかどうか」より、狙っているページが検索結果に出ているかを重視することが大切です。トップページで取りたい語句に別のLPが表示されるようなケースは、ページの役割、表示URL、正規URLの選択を調べる必要があります。実例ではcanonical指定後にエリアのクエリが改善し、広告LPをnoindexに変更した後にビッグクエリが1位へ戻りました。経過を分けて見ることが大切です。
『canonicalを設定すれば100%従う』という誤解
canonicalは指定しただけでGoogleが必ず従う命令ではありません。指定元と指定先の内容や、内部リンク・サイトマップなどのシグナルも確認します。広告LPの事例では、一部のクエリの着地先と順位は改善していたため、「効かなかった」と一括りにせず、残ったビッグクエリの課題を別に評価しました。
canonicalが無視される場合は、まずURL検査で実際に選ばれた正規URLを示し、設定元・設定先の内容、内部リンク、サイトマップを一緒に確認することが必要です。ページを残す必要がなければ301、検索結果に出したくないが広告には必要ならnoindexなど、サイトの目的に沿って代案を選ぶことが大切です。
『少しの違いなら重複にならない』という誤解
見出しやメタディスクリプションを変更しただけでは、重複が解決されません。タイトルや説明文を変えるだけでは、ページが提供する中身や検索意図は変わりません。各ページに独自の検索需要と役割があるかを先に確認し、あるなら内容を分ける、ないなら統合・正規化を検討することが重要です。
「実質的に同じ内容」の判定基準について、地域や条件の名前だけ違う求人一覧でも、求人件数と掲載内容がほぼ同じで、どちらも同じ検索意図に応えるなら重複を疑うべきです。一方、異なる地域の求人が十分あり、別の需要を受けるなら残す価値があります。文章の一致率だけでは決めないことが重要です。
重複コンテンツ対策後の効果測定方法
短期的には実装確認と、Googleが選んだ正規URL・インデックス状況・クロールの変化を見ます。長期的には狙ったページ群の順位、自然検索流入、CVを追うことが大切です。URLが除外された数だけでは、事業上の改善を測れません。
Google Search Consoleでの効果測定
「有効」の件数が増えることを目標にするべきではなく、不要な絞り込みURLを整理すれば登録数が減るのは自然なことです。重要なページが登録され、狙った検索面で表示・流入を獲得できるかを見ることが重要です。
検索パフォーマンスレポートでは、変更したURL群ごとに主要クエリの表示回数、クリック数、掲載順位を追います。さらにクエリ別に「想定したページへ着地するようになったか」を確認します。ドレス一覧とランキングのように共存させたページなら、それぞれが固有のクエリを維持できているかを見る。統合したなら、旧ページだけが獲得していたクエリを統合先が引き継げたかを見る。インデックス件数だけでなく、流入とCVまで追って初めて、対処が事業上正しかったか判断できます。
改善前後の流入数・順位の比較
重複コンテンツ対策による流入増と、他のSEO施策による増加をどう区分するかは、施策の実装日と対象URL群を記録し、同時期に行ったコンテンツ追加や内部リンク変更、アルゴリズム変動を併せて見ることが重要です。大規模アパレルECでは重複対策が自然検索流入約2倍の大きな改善要因でしたが、ほかの施策も並行しているため、個別施策ごとの増分を機械的に切り分けた数字とはしていません。
対策実装後、順位が下がってから上がる現象は正常なケースもありますが、下がったらすべて正常な一時変動とは判断してはいけません。対象ページの正規URL、リダイレクト、内部リンク、失った検索意図を点検することが必要です。
今すぐできる重複コンテンツ対策の実行手順
各フェーズでの役割分担は、SEO側で検索市場、ページの役割、残すURLと施策要件を定義し、エンジニアとURL生成・テンプレート・リダイレクトの実装方法を詰めることが大切です。事業側には、広告LPや商品・求人ページを残す必要性を確認してもらいます。公開後はSEOと運用担当で計測と改善を続けることが重要です。
1. 重複URLを発見する
Search Consoleは出発点ですが、それだけで十分とは言えません。実際にGoogleが選んだURLと流入を見たうえで、サイト側でどのパラメータやページタイプが生成されているか、内部リンクがどこを指すかまで調べることが必要です。複数のツールを組み合わせる場合の実施順序は、まずSearch Consoleで重要ページの選択状況と検索流入を把握することから始めます。次にURL一覧やクロール結果から、パラメータ、掛け合わせ、広告LPなどの発生源を確認します。必要に応じてログや検索需要も見て、ページ群ごとの優先順位と対処方法を決めることが効率的です。
2. 優先度と対策方針を決める
重複コンテンツの優先度評価に必要なデータは、対象URL数、ページタイプ、検索需要、既存流入・CV、Googleの選択した正規URL、不要URLが検索に残るか、内部リンク、実装工数です。大規模サイトでは、検索対象から外すことで失うロングテール需要も合わせて確認します。まずURL群を「残す/統合する/正規化する/検索対象から外す」に分け、例外条件まで仕様化することが実装の前提です。
SEOだけでは決めきれず、広告LPを使い続けるか、商品・求人の一覧をどこまで公開するかは事業や運用に関わります。検索上の主役をSEO側で提案し、広告、商品、開発の担当者とページの用途と制約を擦り合わせることが必要です。
3. 実装し、重要ページへの影響を確認する
技術実装に専門知識が必要な場合、まずSEO側で、どのURL群をどう扱うか、対象条件と例外を仕様に落とします。その上でエンジニアに生成ルールやテンプレート変更の影響範囲を確認してもらいます。Shopify案件でも、サイト構造と正規化の方針を整理したうえで、実装は先方エンジニアと調整することが重要です。
重複コンテンツ対策ならIMANIにおまかせください
IMANIでは、重複URLを見つけてタグを付けるだけでなく、どの検索市場をどのページ群で獲得するかから設計します。EC・求人・ポータルなど大量URLを持つサイトで、検索需要、事業上の用途、システム制約を踏まえ、カテゴリ、内部リンク、クロール、インデックス、正規化まで一体で整理することが私たちの強みです。実装と効果検証を支援し、ビジネス成果に直結する対策を実現します。
クライアントからよく寄せられる質問は「どのページをindexさせるべきか」「canonicalとnoindexのどちらを使うべきか」「広告LPや絞り込みを残しながら評価を集められるか」などです。まず検索市場とページの役割を整理し、重要なページの流入やGoogleの正規URLの選択を確認して、施策の優先順位を決めることが重要です。
検索に出したいページと、広告・サイト内導線のために残すページをどう分けるか。大規模サイトでは、ページ群ごとに判断が必要です。自社サイトの重複やURL設計についてお悩みなら、IMANIへご相談ください。検索市場とサイト構造の両面から、優先順位と実装方針を整理します。